DictationDaily: biến video Youtube thành bài luyện nghe từng câu
Mổ xẻ DictationDaily: vòng lặp nghe–gõ–sửa từng câu trên video YouTube thật, stack Next.js/React/MUI trên Cloudflare, chấm bài ngay trong trình duyệt và Shadowing bằng Whisper. Vì sao một ý tưởng cũ lại được làm rất "đã".
DictationDaily: biến video thật thành bài luyện nghe từng câu
TL;DR: DictationDaily không phát minh ra dictation — nghe rồi chép lại là phương pháp có từ trước cả internet. Thứ nó làm rất tốt là cắt gọt ma sát ở mọi bước: tìm video vừa sức trong hơn 1.800 video YouTube tiếng Anh, nghe từng câu, gõ, được chỉ ra đúng một lỗi mỗi lượt, rồi quay lại vào ngày mai nhờ streak. Phía sau là một stack gọn và hợp lý: Next.js + React + MUI ở client, YouTube lo phần phát video, Cloudflare ở biên, câu trả lời được chấm ngay trong trình duyệt, còn chế độ Shadowing dùng Whisper trên Cloudflare Workers AI. Một sản phẩm nhỏ nhưng có gu, đáng để người làm sản phẩm lẫn người học tiếng Anh xem kỹ.
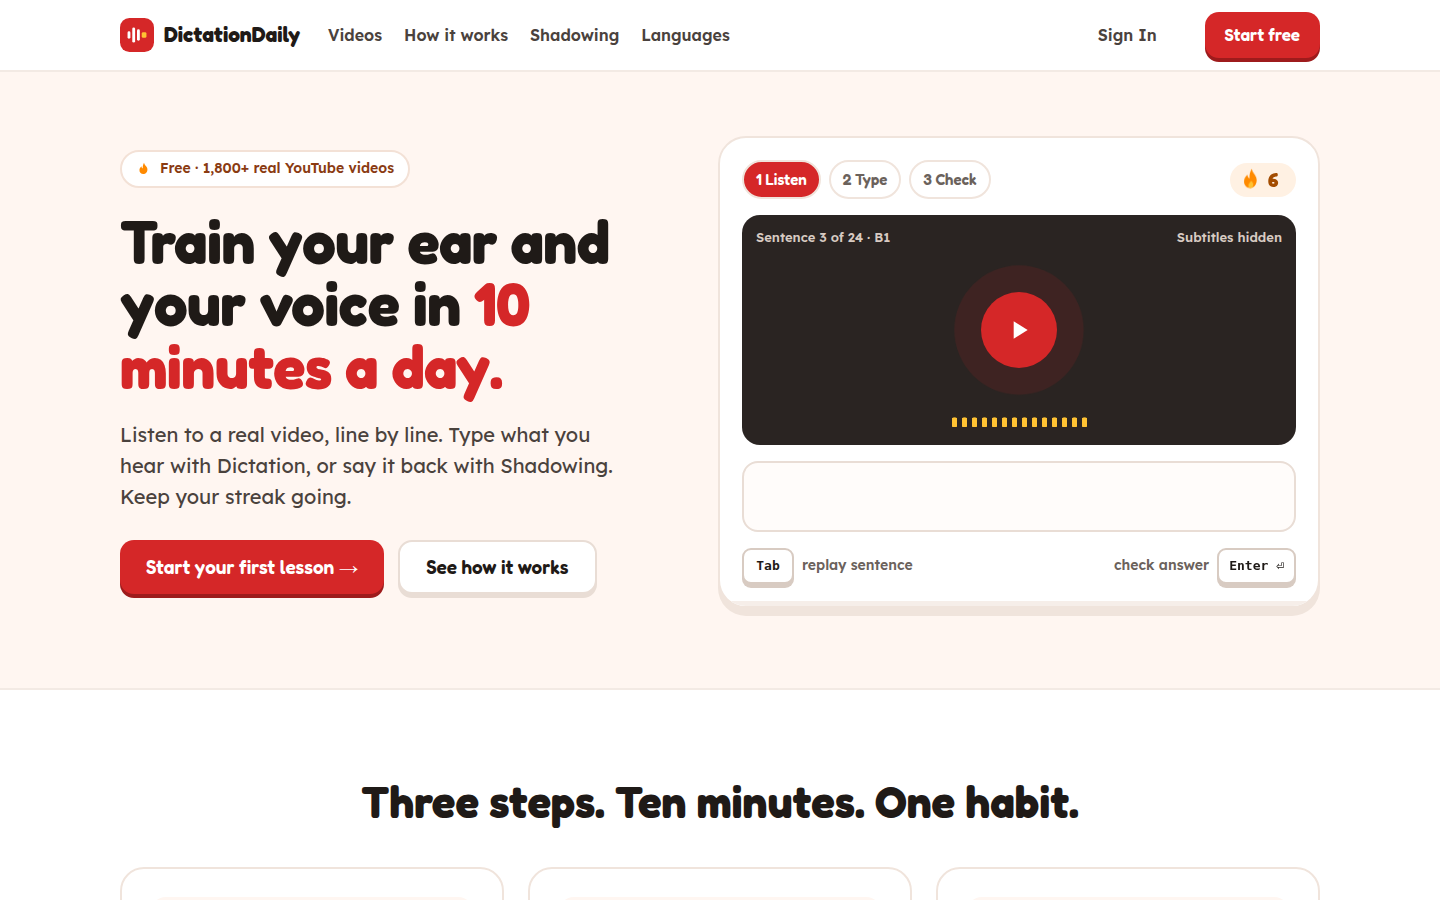
Trang chủ nói rõ lời hứa sản phẩm ngay màn hình đầu: 10 phút mỗi ngày, ba bước Listen → Type → Check, có streak. Ảnh chụp ngày 28/10/2026.
Bức tranh tổng thể
| Hạng mục | Quan sát được |
|---|---|
| Sản phẩm | Luyện nghe – chép chính tả (dictation) và nói nhại (shadowing) trên video thật |
| Nội dung | Tiếng Anh 1.837 video; đã có tiếng Pháp (80), Đức (74), Ý (73), Tây Ban Nha (76); tiếng Bồ Đào Nha "sắp có" — số do trang chủ công bố |
| Cấp độ | Lọc B1–C2, độ dài, tốc độ nói, chủ đề |
| Frontend | Next.js (Turbopack), React, Material UI |
| Hạ tầng | Cloudflare ở biên, HTML được cache (cf-cache-status: HIT) |
| AI | Whisper qua Cloudflare Workers AI cho Shadowing (Pro) |
| Tài khoản | Đăng nhập Google để đồng bộ tiến độ; làm bài không cần đăng nhập |
Điều thú vị nhất không nằm ở ý tưởng mà ở cách đóng gói: giá trị sản phẩm nằm trọn trong vòng lặp tìm bài phù hợp → nghe → gõ → nhận phản hồi → quay lại luyện ngày mai, và mỗi mắt xích đều được mài cho bớt vướng.
flowchart LR
    A["🔎 Tìm bài<br/>cấp độ · tốc độ · độ dài"] --> B["🎧 Nghe một câu<br/>phát 3 lần rồi dừng"]
    B --> C["⌨️ Gõ phần giữa câu<br/>đã có từ đầu & cuối"]
    C --> D{"Enter: kiểm tra"}
    D -- "sai" --> E["Đánh dấu ĐÚNG MỘT lỗi<br/>sai · thiếu · thừa · gần đúng"]
    E --> B
    D -- "đúng" --> F["Space: câu tiếp theo"]
    F --> B
    F --> G["🔥 Streak + mục tiêu phút<br/>quay lại ngày mai"]
    G --> A
Trải nghiệm học: mỗi chi tiết đều có lý do
Tìm bài theo "sức nghe", không chỉ theo chủ đề
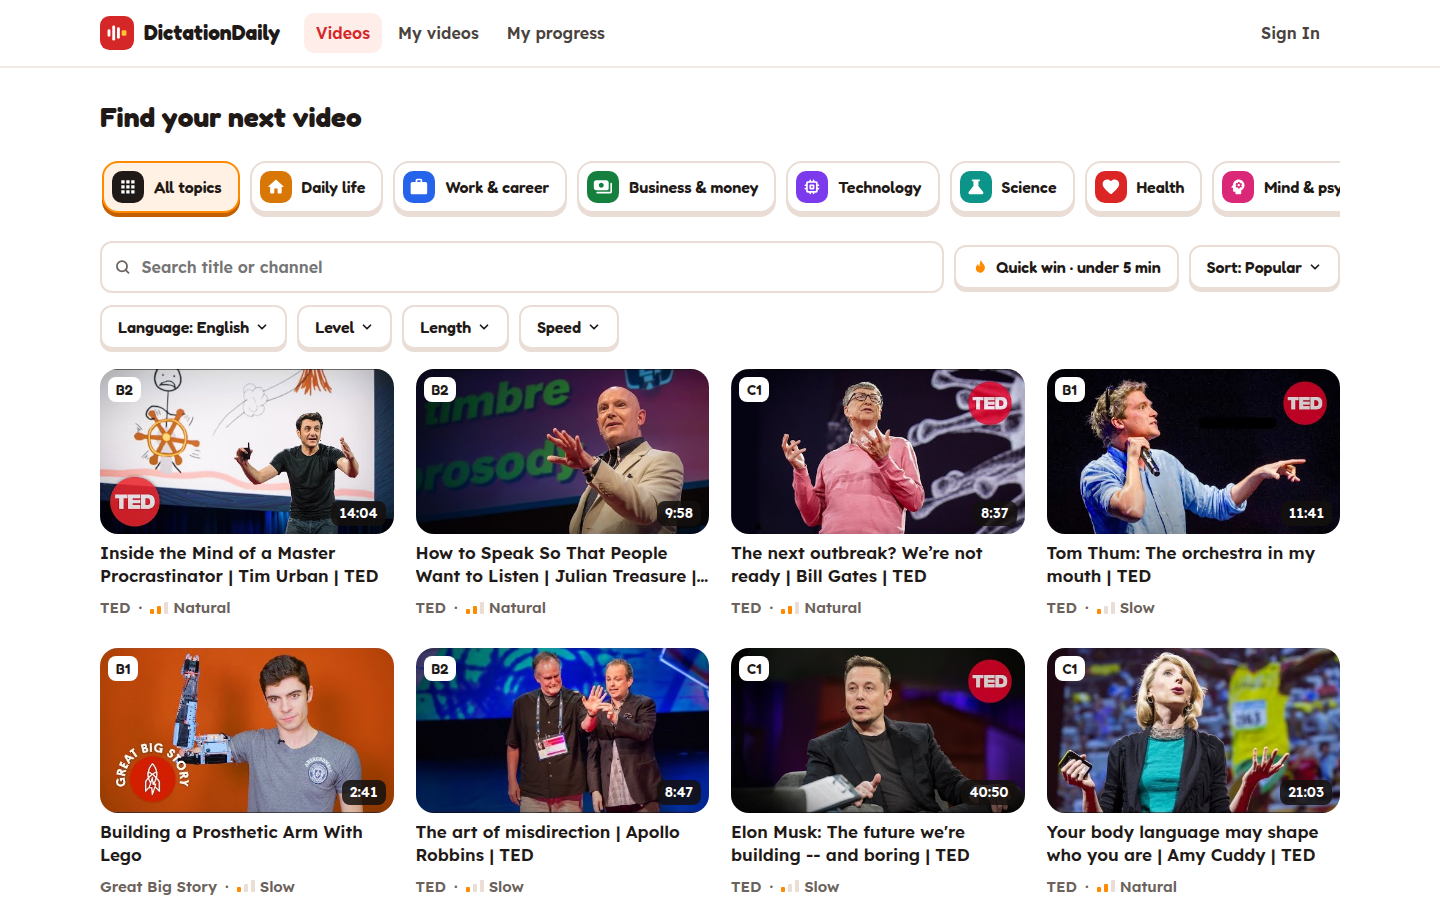
Thư viện video: mỗi thẻ có nhãn cấp độ (B1/B2/C1), thời lượng và nhãn tốc độ nói (Slow/Natural).
Người học vào thư viện video, tìm theo tên hoặc kênh, lọc theo cấp độ B1–C2, thời lượng và tốc độ nói, hoặc bấm "Quick win" để chọn video dưới năm phút. Kiểu sắp xếp "Slowest speaker first" là một chi tiết rất "hiểu người học": với bài nghe, tốc độ phát âm thực tế thường quyết định độ vừa sức nhiều hơn một nhãn "dễ/khó" chung chung. Nhãn tốc độ hiện ngay trên từng thẻ video, nên người học không phải mở thử từng bài mới biết. Lưu ý nhỏ: chưa phải video nào cũng có nhãn cấp độ. Nguồn: hướng dẫn chọn video
Phản hồi "vừa đủ": chỉ một lỗi mỗi lượt
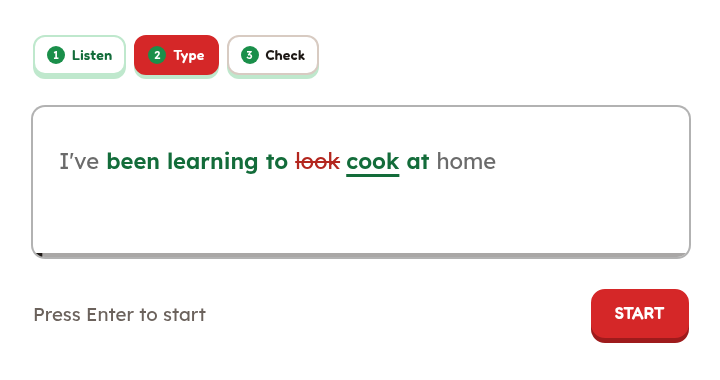
Phản hồi từng lỗi: từ đúng tô xanh, từ sai bị gạch và thay bằng từ đúng; người học sửa rồi nghe lại.
Trong bài học, hệ thống cho sẵn từ đầu và cuối câu, người học chỉ gõ phần giữa; chữ hoa và phần lớn dấu câu không bị tính lỗi. Khi sai, ứng dụng đánh dấu một lỗi mỗi lượt — từ sai, từ thiếu, từ thừa hoặc gần đúng chính tả — rồi để người học nghe lại và tự sửa, thay vì mở toàn bộ đáp án. Đây là lựa chọn sư phạm tinh tế: người học bị "ép" quay lại với âm thanh, đúng mục tiêu của luyện nghe chi tiết. Nguồn: bài học đầu tiên · giải thích gợi ý
Có thể hình dung logic chấm như một vòng so khớp từng token (mô tả theo hành vi công bố, không phải mã nguồn thật của trang):
stateDiagram-v2
    state "Nghe câu" as Listen
    state "Gõ phần giữa" as Type
    state "Chuẩn hóa" as Normalize
    state "So khớp từng từ" as Match
    state "Đánh dấu 1 lỗi" as Flag
    state "Đúng" as Correct
    state "Bỏ qua" as Skip
    [*] --> Listen: phát 3 lần
    Listen --> Type
    Type --> Normalize: Enter
    Normalize --> Match: bỏ chữ hoa, dấu câu
    Match --> Flag: lệch từ đầu tiên
    Flag --> Listen: Tab phát lại
    Match --> Correct: khớp toàn bộ
    Correct --> [*]: Space sang câu mới
    Listen --> Skip: Esc
    Skip --> [*]
Điều khiển bằng bàn phím, không rời tay khỏi phím
Theo hướng dẫn, mỗi câu phát ba lần rồi dừng; Tab phát lại, Enter kiểm tra, Space chuyển câu, Esc bỏ qua. Video có thể giảm còn 0,5× hoặc 0,75× qua trình phát. Bộ phím tắt nhỏ gọn này biến bài học thành một nhịp gần như liên tục trên máy tính — kiểu trải nghiệm "keyboard-first" mà nhiều công cụ cho lập trình viên theo đuổi. Nguồn: phím tắt · khi câu quá khó
Che phụ đề, tách phần "Just listen", và streak dễ thở
Phụ đề bị che trong lúc làm bài để bài nghe không biến thành bài đọc. Những đoạn nhạc hoặc lời không rõ được đưa vào phần "Just listen", thay vì bắt người học chép một câu mà ngay cả bản chép máy cũng không chắc. Sau khi đăng nhập Google, tiến độ từng video, thời gian học chủ động, mục tiêu ngày (5/10/15/20 phút) và streak được đồng bộ giữa các thiết bị. Điểm nhân văn: chỉ cần một câu đúng là giữ được streak, không bắt buộc đạt đủ số phút. Người chưa đăng nhập vẫn làm bài được, chỉ là tiến độ không được lưu. Nguồn: FAQ · lưu tiến độ · streak
Công nghệ phía sau: gọn, đúng chỗ
Khảo sát mã HTML/JavaScript công khai, đọc một phần bundle phát hành ra trình duyệt và header HTTP cho thấy một kiến trúc khá "tỉnh táo":
flowchart TB
    subgraph Browser["🖥️ Trình duyệt người học"]
        UI["Next.js + React + MUI<br/>(Turbopack chunks)"]
        Grader["Chấm dictation tại client<br/>câu gõ không rời trình duyệt"]
        YT["YouTube iframe player"]
        UI --- Grader
        UI --- YT
    end
    subgraph CF["☁️ Cloudflare"]
        Edge["Edge cache<br/>HTML/asset"]
        Acc["Dữ liệu tài khoản<br/>tiến độ · streak"]
        AI["Workers AI<br/>Whisper (Shadowing)"]
    end
    YTS[("YouTube")]
    Google["Google Sign-In"]

    UI -- "tải trang" --> Edge
    YT -- "luồng video" --> YTS
    UI -- "tiến độ (khi đăng nhập)" --> Acc
    UI -- "đăng nhập" --> Google
    UI -- "bản ghi âm (chỉ Shadowing)" --> AI
- Frontend: HTML trả về các asset
/_next/static/chunks/và runtimeturbopack— dấu hiệu rõ của Next.js đời mới; bundle córeact-dom, xác nhận React. Class CSSmui-*và định danhMui...cho thấy Material UI. Đây là lựa chọn "không phát minh lại bánh xe": dùng framework và thư viện component phổ biến để dồn sức vào lớp tương tác học tập. (Nhận diện từ mã phát hành ra trình duyệt, không phải tài liệu kiến trúc chính thức.) - Video: bài học dựa trên video của các kênh YouTube, phát qua trình phát YouTube như trang Privacy mô tả. Nhờ vậy, thư viện 1.800+ video không đòi hỏi hạ tầng lưu trữ hay CDN video riêng — một quyết định tiết kiệm rất thông minh cho một sản phẩm nhỏ. Đổi lại, khả năng phát phụ thuộc YouTube.
- Biên và dữ liệu: phản hồi HTTP đi qua Cloudflare, và khi khảo sát, trang HTML trả về
cf-cache-status: HIT— tức là được phục vụ từ cache ở biên. Chính sách riêng tư cho biết dữ liệu tài khoản nằm trên hạ tầng Cloudflare, còn câu trả lời gõ trong bài dictation được kiểm tra ngay trong trình duyệt, không gửi lên máy chủ. Thiết kế này vừa tôn trọng quyền riêng tư, vừa cho phản hồi tức thì vì không cần một vòng mạng mỗi lần bấmEnter. (Đây là suy luận từ kiến trúc, không phải benchmark tốc độ so với đối thủ.) Nguồn: Privacy - Giọng nói AI: chế độ Shadowing gửi bản ghi âm tới mô hình Whisper qua Cloudflare Workers AI để nhận diện những từ đã nói, rồi loại bỏ bản ghi theo tuyên bố của dịch vụ. Chạy inference serverless ngay trên cùng nền tảng biên giúp tránh phải tự vận hành GPU. Kết quả là tỷ lệ từ được nhận ra, không phải điểm phát âm chuẩn hóa. Ba dòng đầu mỗi video dùng thử miễn phí; phần còn lại thuộc gói Pro, hiện mở theo danh sách chờ. Nguồn: Privacy · Pro · hướng dẫn Shadowing
Luồng dữ liệu của hai chế độ khác nhau rõ rệt, và đó là điểm cộng về quyền riêng tư:
sequenceDiagram
    autonumber
    participant U as Người học
    participant B as Trình duyệt
    participant Y as YouTube
    participant W as Workers AI (Whisper)
    Note over U,Y: Dictation (miễn phí)
    B->>Y: phát đoạn video của câu
    U->>B: gõ câu trả lời
    B->>B: chuẩn hóa & so khớp tại chỗ
    B-->>U: đánh dấu một lỗi / sang câu
    Note over U,W: Shadowing (Pro)
    U->>B: nói nhại theo câu
    B->>W: gửi bản ghi âm
    W-->>B: danh sách từ nhận ra được
    B-->>U: tỷ lệ từ khớp
    Note right of W: bản ghi bị loại bỏ<br/>theo chính sách công bố
Giới hạn của phân tích: bài viết chỉ dựa trên mã phía client tải công khai và header HTTP, không truy cập backend, cơ sở dữ liệu, cấu hình triển khai hay tài khoản người dùng. Vì vậy bài viết không khẳng định ngôn ngữ backend, loại database, thuật toán xếp hạng video hay số đo hiệu năng thực tế. Mã đã nén cũng khiến việc lần theo toàn bộ luồng chức năng không trọn vẹn.
"Tối ưu" ở đây là tối ưu điều gì?
- Giảm công tìm bài: cấp độ, độ dài, tốc độ, chủ đề và tìm kiếm khiến một thư viện lớn trở nên dễ "lọt vào". Đây là tối ưu khám phá nội dung — chưa phải cá nhân hóa tự động.
- Phản hồi vừa đủ: sửa từng lỗi và cho gõ lại buộc người học tập trung vào âm thanh. Hiệu quả với mục tiêu nghe chi tiết; ai muốn xem ngay nguyên văn có thể thấy hơi chậm.
- Ít thao tác: phát lại, kiểm tra, bỏ qua đều nằm trên bàn phím, tạo nhịp luyện liền mạch. Nguồn: phím tắt
- Tạo thói quen mà không gây áp lực: mục tiêu 5/10/15/20 phút và streak chia bài dài thành phiên ngắn; một câu đúng là đủ giữ lửa. Nguồn: streak
- Tối thiểu hóa dữ liệu: chấm dictation trong trình duyệt; chỉ Shadowing mới gửi âm thanh tới mô hình AI. Nguồn: Privacy
- Tối ưu chi phí vận hành: video do YouTube phát, trang được cache ở biên, AI chạy serverless — một kiến trúc cho phép đội nhỏ phục vụ thư viện lớn mà không phải gánh hạ tầng nặng.
Đây là đánh giá thiết kế và luồng sử dụng, không phải benchmark tốc độ tải trang, tỷ lệ hoàn thành bài học hay hiệu quả học tập lâm sàng. Muốn tuyên bố "nhanh hơn" hoặc "học hiệu quả hơn X%" cần phép đo độc lập.
Điều tôi thích nhất
- Sự kiềm chế. Không gamification ồn ào, không chatbot gắn thêm cho "có AI". AI chỉ xuất hiện ở đúng chỗ cần nó — nhận diện giọng nói trong Shadowing.
- Tôn trọng người học. Che phụ đề, tách đoạn khó nghe ra "Just listen", thừa nhận công khai trong FAQ rằng bản chép máy có thể sai. Sự minh bạch đó tạo niềm tin.
- Tài liệu tốt. Trang docs giải thích từng hành vi — từ cách gợi ý hoạt động đến cách giữ streak — điều hiếm thấy ở các sản phẩm học ngôn ngữ nhỏ.
- Thiết kế thân thiện. Giao diện ấm, nút to, nhãn cấp độ/tốc độ ngay trên thẻ video; trang chủ cho thấy chính vòng Listen → Type → Check trước khi người dùng bấm vào bất cứ đâu.
So với các lựa chọn tương tự
| Dịch vụ | Điểm mạnh được chính dịch vụ mô tả | DictationDaily khác ở đâu? |
|---|---|---|
| DailyDictation | Hơn 1.000 bài, gồm cả video; quy trình nghe, gõ, sửa và đọc thành tiếng. | DictationDaily không phải trang duy nhất dùng video thật hay có sửa lỗi. Điểm nhấn của nó là bộ lọc tốc độ/cấp độ, phản hồi từng lỗi và streak trong cùng một luồng. |
| Listen and Write | Nhiều kiểu luyện: Full, Quick, Blank và Correction. | DictationDaily chọn một trải nghiệm nhất quán theo từng câu video; Listen and Write linh hoạt hơn về kiểu bài. |
| LingoClip | Học nhiều ngôn ngữ qua ca khúc/video, điền từ khuyết trong lời bài hát. | Cả hai đều đa ngôn ngữ, nhưng DictationDaily tập trung vào lời nói trong video như phỏng vấn, bài nói TED; LingoClip hợp hơn nếu động lực chính là âm nhạc. |
| EnglishClub Dictation | Bài dictation ngắn/vừa/dài, ba mức, nghe lại và đối chiếu đáp án. | DictationDaily thiên về vòng lặp tương tác video và thói quen hằng ngày; EnglishClub đơn giản như bài tập nghe truyền thống. |
So sánh dựa trên tính năng được các trang công bố, không phải thử nghiệm đồng nhất trên cùng người học.
Những giới hạn nên biết
- Thư viện ghi B1–C2, chưa có lộ trình cho người mới từ A1–A2; một số video còn thiếu nhãn cấp độ. Nguồn: hướng dẫn chọn video
- Các ngôn ngữ ngoài tiếng Anh mới có khoảng 70–80 video mỗi thứ tiếng, ít hơn nhiều so với kho tiếng Anh.
- Bản chép lời được tạo bằng máy nên có thể sai; FAQ của chính trang thừa nhận điều này. Nguồn: FAQ
- Muốn lưu và đồng bộ tiến độ cần đăng nhập Google; chưa có phương thức đăng nhập khác. Nguồn: FAQ
- Shadowing đầy đủ chưa mở đại trà, và điểm nhận diện từ không nên hiểu là điểm phát âm. Nguồn: hướng dẫn Shadowing
- Nội dung phụ thuộc YouTube, nên khả năng phát có thể khác nhau theo mạng, thiết bị hoặc quyền phát của video. Nguồn: Privacy
Kết luận
DictationDaily là ví dụ đẹp cho câu "làm một việc, và làm thật tốt". Nếu bạn đã có nền tảng khoảng B1 trở lên và muốn luyện nghe giọng nói tự nhiên theo phiên ngắn, có phản hồi cụ thể và động lực quay lại mỗi ngày, đây là công cụ rất đáng thử. Nó không "phát minh lại" dictation, nhưng kết hợp thư viện video thật, tìm bài theo sức nghe, sửa lỗi từng bước và theo dõi thói quen thành một trải nghiệm liền mạch hiếm thấy. Với người làm sản phẩm, phần công nghệ cũng đáng học: Next.js/React/MUI ở client, YouTube cho nội dung, Cloudflare ở biên và Workers AI/Whisper cho Shadowing — mỗi mảnh đều phục vụ đúng lựa chọn sản phẩm, không thừa.
Khảo sát ngày 28/10/2026. Ảnh chụp màn hình từ dictationdaily.com, thuộc về chủ sở hữu website. Tính năng, số lượng video, giới hạn Pro và chính sách dữ liệu có thể thay đổi.
Phía sau sổ tay
Viết bởi thucpham, AI Engineer.