DETR trên ảnh SPECT: tự động tính RSI để đánh giá mô giáp còn sót sau cắt tuyến giáp
Diễn giải bài báo IEEE SSP 2023: dùng DETR phát hiện tuyến giáp và vai trên ảnh SPECT I-131, tự tính chỉ số RSI để chẩn đoán mô giáp còn sót (F1 0,91). Phân tích chi tiết từng phép thử, công thức và hình minh họa.
Tóm tắt nhanh (TL;DR): Bài báo “Utilizing DETR model on SPECT image to assess remaining thyroid tissues post-thyroidectomy” (IEEE SSP 2023, tr. 537–541) là bước tiếp theo của nghiên cứu NICS 2022. Thay vì để một mạng CNN trả lời thẳng “còn hay không còn mô giáp”, nhóm tác giả cho mô hình DETR (Detection Transformer) khoanh vùng tuyến giáp và vùng vai trên ảnh SPECT I-131, rồi tính một con số định lượng mà bác sĩ hiểu được: RSI (Radioiodine Scan Index), tức tỷ lệ hấp thụ phóng xạ giữa vùng cổ và vùng vai. Một mô hình hồi quy logistic dựa trên RSI cho kết quả chẩn đoán F1 = 0,91 (Accuracy 0,96, Precision 0,86, Recall 0,95), tốt hơn cách phân loại trực tiếp bằng ResNet-50 (F1 = 0,88). Bài báo cũng đề xuất một thước đo đánh giá mới (RSIA) để chọn mô hình phát hiện theo đúng mục tiêu lâm sàng thay vì chỉ nhìn mAP.
Thông tin bài báo
| Mục | Nội dung |
|---|---|
| Tiêu đề | Utilizing DETR model on SPECT image to assess remaining thyroid tissues post-thyroidectomy |
| Tác giả | Minh Lai Phu, Thanh Trung Nguyen, Thanh Vinh Pham, Thai Ha Nguyen, Duc Thuc Pham, Minh Duc Chu, Chi Thanh Nguyen, Quoc Long Tran, Duc Thuan Nguyen, Ngoc Ha Le, Hong Son Mai, Thi Nhung Nguyen, Thi Phuong Nguyen, Quoc Khanh Le, Nam Thang Dang |
| Đơn vị | Khoa Điện tử, Trường Điện – Điện tử, ĐH Bách khoa Hà Nội (HUST); Khoa CNTT, ĐH Công nghệ – ĐHQGHN (UET); Khoa Trang thiết bị y tế và Khoa Y học hạt nhân, Bệnh viện TWQĐ 108; Viện CNTT, Viện Khoa học và Công nghệ quân sự |
| Hội nghị | SSP 2023, tr. 537–541 |
| Tài trợ | Đề tài TXTCN.21.23, Đại học Quốc gia Hà Nội |
| Bài toán | (1) Phát hiện đối tượng: tuyến giáp còn sót và vùng vai; (2) Chẩn đoán nhị phân còn mô giáp / không còn mô giáp từ chỉ số RSI |
| Mô hình | DETR (backbone ResNet-50) + hồi quy logistic trên RSI |
| Kết quả chính | F1 0,91 · Thyroid [email protected] = 0,73 · Shoulder [email protected] = 0,604 · RSIA = 0,457 |
Từ “phân loại” sang “phát hiện + đo đạc”: vì sao đổi hướng?
Ở bài NICS 2022, mô hình ResNet-50 nhìn cả ảnh rồi trả về một nhãn. Cách làm này có hai điểm yếu khi đưa vào lâm sàng:
- Khó giải thích. Mô hình nói “còn mô giáp” nhưng không nói ở đâu và mức độ bao nhiêu. Heatmap giúp được một phần nhưng vẫn là suy đoán gián tiếp.
- Không khớp quy trình của bác sĩ. Bác sĩ y học hạt nhân thường so mức tập trung phóng xạ ở giường tuyến giáp với một vùng nền (background) để đánh giá. Một con số tỷ lệ như vậy dễ kiểm tra lại, dễ đặt ngưỡng và dễ so sánh giữa các lần chụp.
Bài SSP 2023 làm đúng theo quy trình đó: tìm vùng → đo hấp thụ → tính tỷ lệ → ra quyết định. Mô hình học sâu chỉ đảm nhận phần “tìm vùng”, còn phần quyết định là một công thức minh bạch cộng với một mô hình logistic một biến.
Toàn cảnh pipeline
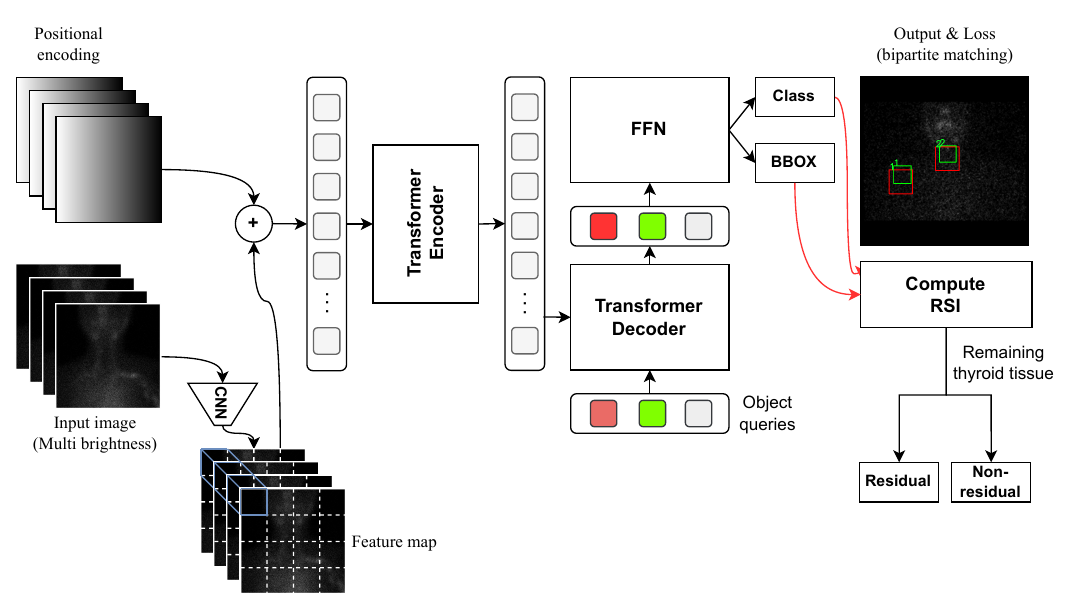
Hình 2 (trích bài báo). Hộp đỏ là dự đoán của mô hình, hộp xanh lá là nhãn thật (ground truth).
flowchart LR
    A[Ảnh xạ hình toàn thân<br/>256×1024] --> B[Cắt vùng đầu – cổ<br/>256×256]
    B --> C[Tạo 4 phiên bản<br/>độ sáng khác nhau]
    C --> D[DETR<br/>ResNet-50 + Transformer]
    D --> E[Hộp tuyến giáp B_T]
    D --> F[Hộp vai B_S]
    E --> G["Tính RSI = U(E_T) / U(E_S)"]
    F --> G
    G --> H[Hồi quy logistic]
    H --> I{Còn mô giáp?}
Dữ liệu và tiền xử lý
Bộ dữ liệu MCHSP400
Các bác sĩ Khoa Y học hạt nhân, Bệnh viện TWQĐ 108 đã thu thập và gán nhãn bộ dữ liệu MCHSP400. Phần dữ liệu dùng cho thực nghiệm gồm 396 ca ảnh xạ hình SPECT với I-131, mỗi ca có:
- nhãn chẩn đoán còn mô giáp (positive / residual) hoặc không còn (negative / non-residual);
- bounding box cho vùng tuyến giáp (vùng cổ) và vùng vai.
Phân tích kích thước các hộp cho thấy phần lớn đối tượng thuộc loại nhỏ và trung bình, đây là điểm khó với nhiều mô hình phát hiện. Toàn bộ dữ liệu được thu thập với sự cho phép của Bệnh viện TWQĐ 108.
| Tập | Số ca | Vai trò |
|---|---|---|
| Train | 278 | Huấn luyện mô hình |
| Validation | 79 | Chọn mô hình tốt nhất (theo mAP hoặc theo RSIA) |
| Test | 39 | Đánh giá cuối cùng trên dữ liệu chưa thấy |
| Tổng | 396 |
Bước 1: Cắt vùng đầu – cổ
Ảnh xạ hình toàn thân có kích thước 256×1024. Ngoài tuyến giáp, ảnh còn chứa nhiều vùng hấp thụ iốt khác như tuyến nước bọt, dạ dày, bàng quang. Với bài toán này chúng chỉ là nhiễu. Ảnh được cắt về 256×256, chỉ giữ vùng đầu – cổ – vai, nhờ đó mô hình không bị “phân tâm” bởi các cơ quan không liên quan.
Bước 2: Ảnh nhiều mức sáng (multi-brightness)
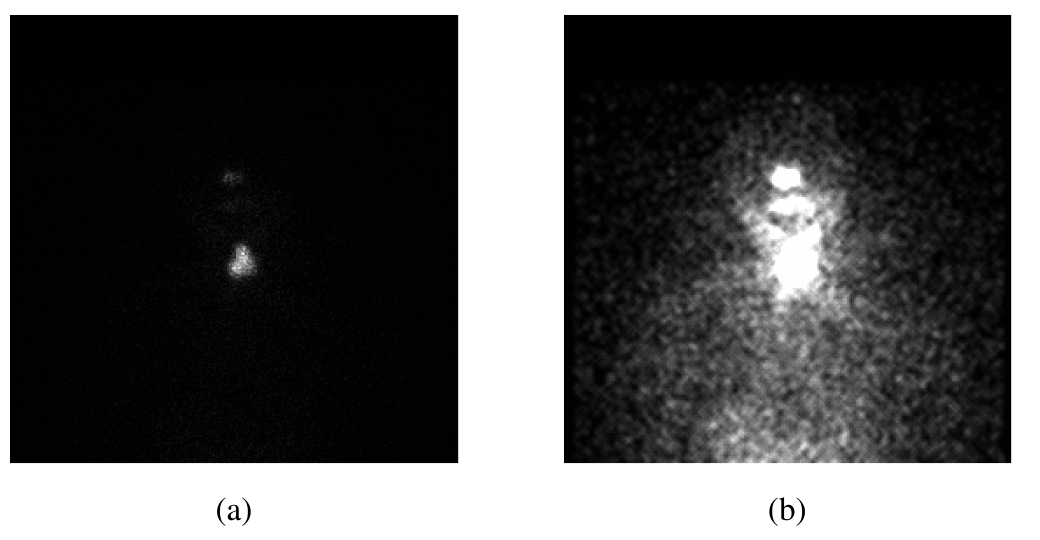
Hình 1 (trích bài báo). (a) Ảnh gốc, đường viền cơ thể không rõ. (b) Ảnh tăng sáng, đường viền cơ thể hiện rõ.
Ảnh SPECT có dải động rất lệch: vùng hấp thụ mạnh (tuyến giáp còn sót) sáng chói, còn phần cơ thể còn lại chỉ có vài photon tán xạ nên gần như đen. Nếu chỉ dùng ảnh gốc, mô hình gần như không thấy vai vì vai không hấp thụ iốt, nó chỉ hiện ra như một vùng nền mờ.
Giải pháp của bài báo là tạo nhiều phiên bản độ sáng của cùng một ảnh rồi ghép chúng thành các kênh đầu vào. Ý tưởng giống cách bác sĩ chẩn đoán hình ảnh chỉnh “cửa sổ” (window/level) khi đọc CT: mỗi cửa sổ làm nổi một loại chi tiết.
Một cách hiện thực đơn giản cho phép biến đổi này (mang tính minh họa) là nhân cường độ với các hệ số khác nhau rồi cắt ngưỡng:
Đầu vào cho mô hình khi đó là một tensor kênh . Kênh (ảnh gốc) giữ thông tin về điểm hấp thụ mạnh (tuyến giáp), còn các kênh sáng hơn làm lộ đường viền cơ thể và vai. Bài báo khảo sát và chọn (xem Phép thử 3).
Vì sao CNN thông thường gặp khó?
Các mô hình phát hiện dựa trên CNN như Faster R-CNN và YOLOv7 gồm một mạng trích xuất đặc trưng (backbone, thường huấn luyện sẵn trên ImageNet) và các lớp phía sau để dự đoán hộp. Backbone CNN rất giỏi bắt đặc trưng cục bộ: cạnh, kết cấu, khối sáng.
Vấn đề nằm ở chỗ CNN dùng nhiều tầng pooling / stride để thu nhỏ bản đồ đặc trưng. Điều này giảm chi phí tính toán nhưng làm mất dần quan hệ không gian toàn cục giữa các vùng xa nhau trong ảnh.
Với bài toán này, quan hệ toàn cục lại là manh mối chính:
- Ở ca đã cắt sạch mô giáp, vùng cổ gần như không có gì sáng. Mô hình phải đoán vị trí giường tuyến giáp dựa vào hình dáng cơ thể và vị trí tương đối so với vai.
- Vai không hấp thụ iốt, gần như không có kết cấu riêng. Vị trí của vai chỉ suy ra được từ đường viền cơ thể và quan hệ với cổ, đầu.
Nói cách khác, mô hình cần trả lời câu hỏi kiểu “vai nằm ở đâu so với cổ?”. Đó là quan hệ tầm xa, đúng thứ mà cơ chế attention của Transformer xử lý tốt.
DETR hoạt động thế nào?
DETR (DEtection TRansformer) do Carion và cộng sự (Facebook AI) giới thiệu ở ECCV 2020. Nó coi bài toán phát hiện là dự đoán một tập hợp (set prediction): mô hình trả thẳng ra một tập các cặp (lớp, hộp), không cần anchor box và không cần bước hậu xử lý NMS (non-maximum suppression).
1. Backbone CNN và positional encoding
Ảnh đầu vào đi qua ResNet-50 để tạo bản đồ đặc trưng . Bản đồ này được trải phẳng thành “token”. Vì Transformer không tự biết vị trí của token, DETR cộng thêm positional encoding dạng sin – cos (theo Vaswani và cộng sự, 2017):
DETR áp dụng công thức này riêng cho trục và trục rồi ghép lại, nên mỗi token “biết” mình nằm ở hàng nào, cột nào.
2. Transformer encoder: self-attention
Mỗi tầng encoder cho mọi vị trí nhìn vào mọi vị trí khác qua cơ chế self-attention:
trong đó là các phép chiếu tuyến tính của token. Trọng số cho biết vị trí này “quan tâm” vị trí kia bao nhiêu. Một token ở vùng vai có thể nhìn trực tiếp vào token ở vùng cổ, dù hai vùng cách nhau nửa bức ảnh. Đây là lý do DETR nắm được quan hệ không gian toàn cục mà CNN dễ đánh mất.
3. Transformer decoder và object queries
Decoder nhận vector học được gọi là object queries (bài DETR gốc dùng ). Mỗi query giống một “ô trống” hỏi: “trong ảnh có đối tượng nào ứng với tôi không?”. Qua các tầng cross-attention với đầu ra encoder, mỗi query trở thành một embedding, rồi một FFN (mạng truyền thẳng) dự đoán:
- lớp : tuyến giáp, vai, hoặc (“không có đối tượng”);
- hộp , chuẩn hóa về .
4. Ghép cặp lưỡng phân (bipartite matching) và hàm mất mát Hungarian
Vì đầu ra là một tập dự đoán không có thứ tự, DETR cần biết dự đoán nào ứng với nhãn nào. Gọi là tập nhãn thật (được đệm thêm cho đủ phần tử). DETR tìm hoán vị có chi phí ghép nhỏ nhất bằng thuật toán Hungarian:
Sau khi ghép xong, mô hình được huấn luyện bằng Hungarian loss:
với hàm mất mát cho hộp là tổ hợp của L1 và Generalized IoU:
trong đó là hộp nhỏ nhất bao cả và (DETR gốc dùng , ).
Ý nghĩa thực tế: việc ghép một – một buộc mỗi đối tượng thật chỉ được “nhận” bởi đúng một query. Vì thế DETR không sinh nhiều hộp trùng nhau và không cần NMS. Đây là điểm bài báo gọi là “bipartite loss gán tường minh mỗi hộp dự đoán với một hộp thật hoặc hộp rỗng”.
Vì sao bài báo chọn DETR?
Theo nhóm tác giả:
- DETR khắc phục điểm yếu của CNN trong việc nắm quan hệ không gian.
- Tốc độ dự đoán nhanh hơn các mô hình hai giai đoạn như Faster R-CNN, Mask R-CNN.
- Làm việc tốt với đối tượng nhỏ và trung bình trong bộ dữ liệu này.
- Không cố định kích thước ảnh đầu vào, có thể dùng 256×256 hay 512×512.
Ghi chú thêm của người viết: Với ảnh tự nhiên (COCO), DETR gốc thường được biết là yếu hơn với vật thể nhỏ và hội tụ chậm. Ở bài toán này, “nhỏ” là kích thước tương đối trong ảnh 256×256, và số đối tượng mỗi ảnh rất ít (một tuyến giáp, hai vai), vì vậy lợi thế về quan hệ toàn cục của DETR lấn át nhược điểm đó.
Chỉ số RSI: biến hộp thành con số chẩn đoán
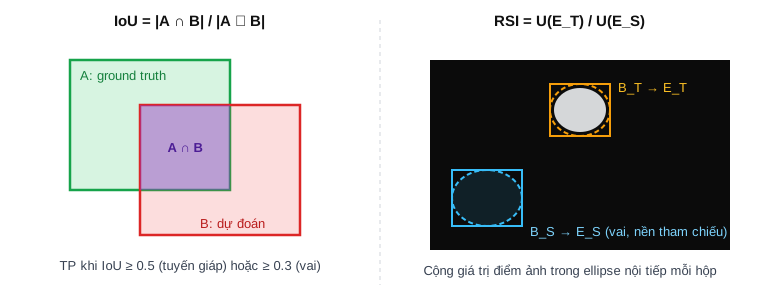
RSI (Radioiodine Scan Index) đo xem vùng cổ hấp thụ iốt phóng xạ nhiều hơn vùng nền bao nhiêu lần. Vùng nền được chọn là vai, vì vai gần cổ, cùng độ sâu mô mềm tương tự nhưng không có mô giáp.
Công thức
Với mỗi hộp (hộp tuyến giáp hoặc hộp vai ), lấy ellipse nội tiếp của hộp. Nếu hộp có tâm , rộng , cao thì:
Lượng hấp thụ (uptake) trong một vùng là tổng giá trị điểm ảnh trong vùng đó:
Áp dụng cho ellipse của vai:
Và RSI là tỷ số giữa hấp thụ ở tuyến giáp và ở vai:
Trong đó là giá trị điểm ảnh tại (đếm photon trên ảnh gốc), là ellipse nội tiếp hộp tuyến giáp và hộp vai.
Vì sao dùng ellipse và vì sao chia cho vai?
- Ellipse thay vì hộp chữ nhật: tuyến giáp và vùng vai có dạng tròn – bầu dục. Bốn góc hộp chủ yếu là nền, nếu cộng vào sẽ làm “loãng” tín hiệu. Ellipse nội tiếp bám sát hình dạng thật hơn.
- Chia cho vai (chuẩn hóa): tổng số đếm tuyệt đối phụ thuộc vào liều I-131 (2 hay 5 mCi), thời gian từ lúc uống thuốc đến lúc chụp, thời gian ghi hình và máy chụp. Lấy tỷ số với một vùng nền trên cùng bức ảnh sẽ triệt tiêu phần lớn các yếu tố này. Đây cũng là nguyên lý của các chỉ số “target-to-background ratio” quen thuộc trong y học hạt nhân.
Từ RSI đến chẩn đoán: hồi quy logistic
RSI là một số dương có phân bố lệch, nên được xem trên thang log (Hình 3). Bộ phân loại là hồi quy logistic một biến:
Mô hình kết luận “còn mô giáp” khi xác suất vượt 0,5, tương đương với RSI vượt ngưỡng . Như vậy toàn bộ quyết định thu về một ngưỡng duy nhất mà bác sĩ có thể kiểm tra, thảo luận và điều chỉnh. Đây là ưu điểm lớn về khả năng giải thích so với một mạng phân loại hộp đen.
Hồi quy logistic được huấn luyện trên RSI tính từ hộp ground truth (hộp do bác sĩ vẽ). Khi chạy thật, RSI được tính từ hộp do DETR dự đoán rồi đưa vào chính mô hình logistic đó.
Thước đo đánh giá
IoU và mAP cho bài toán phát hiện
IoU (Intersection over Union) đo mức trùng khớp giữa hộp dự đoán và hộp thật :
Một dự đoán được tính là đúng (TP) nếu IoU vượt một ngưỡng . Với mỗi lớp, sắp các dự đoán theo độ tin cậy giảm dần rồi vẽ đường Precision – Recall. AP (Average Precision) là diện tích dưới đường này (theo cách nội suy của PASCAL VOC):
mAP@t là trung bình AP trên các lớp ở ngưỡng IoU :
Bài báo dùng:
- [email protected] cho tuyến giáp: đây là vùng có tín hiệu rõ, cần khoanh chính xác.
- [email protected] cho vai: theo các bác sĩ điều trị, vai là vùng tham chiếu ít bị chiếu xạ và mỗi bác sĩ khoanh vai theo cảm nhận riêng. Nhãn của vai vì vậy có độ dao động lớn, nên yêu cầu IoU ≥ 0,5 sẽ “phạt” mô hình vì những khác biệt không có ý nghĩa lâm sàng. Mô hình chủ yếu phải xác định vai dựa vào vị trí và quan hệ không gian.
RSIM và RSIA: thước đo bám sát mục tiêu lâm sàng
mAP đo xem hộp có khớp nhãn không, nhưng điều bác sĩ thật sự cần là RSI tính từ hộp dự đoán có gần RSI thật không. Hai hộp lệch nhau vài điểm ảnh có thể làm IoU giảm mạnh nhưng gần như không đổi RSI, và ngược lại.
Vì vậy bài báo đề xuất RSI Match (RSIM). Mô hình có thể sinh nhiều hộp cho mỗi vùng, nên ta xét cặp (hộp tuyến giáp, hộp vai) có độ tin cậy trung bình cao nhất. Ca bệnh được tính là dự đoán đúng nếu có ít nhất một cặp cho RSI lệch khỏi RSI thật không quá :
trong đó:
- là RSI tính từ hộp ground truth;
- là chỉ số của một cặp (hộp tuyến giáp, hộp vai) trong cặp có độ tin cậy cao nhất;
- là RSI tính từ cặp hộp dự đoán thứ ;
- là sai số chấp nhận được, tính trên thang log-RSI (cùng thang với Hình 3). So trên thang log nghĩa là so theo tỷ lệ chứ không theo hiệu tuyệt đối, nên ca có RSI lớn và ca có RSI nhỏ được đối xử công bằng như nhau.
RSIA (RSI Accuracy) là tỷ lệ ca có RSIM = 1 trên toàn tập đánh giá:
Bài báo dùng và : lấy tối đa 2 hộp tuyến giáp và 2 hộp vai có độ tin cậy cao nhất, tạo ra cặp để tính RSI. Khi chẩn đoán thật, chỉ dùng một cặp gồm hộp tốt nhất của mỗi lớp (tổng độ tin cậy cao nhất).
Chỉ số phân loại
Bước chẩn đoán cuối dùng các chỉ số quen thuộc tính từ ma trận nhầm lẫn (TP, TN, FP, FN):
Với bài toán này, Recall (độ nhạy) đặc biệt quan trọng vì bỏ sót mô giáp còn sót (FN) có thể khiến bệnh nhân không được điều trị tiếp đúng lúc. Xem thêm phần giải thích chi tiết các chỉ số ở bài NICS 2022.
Các phép thử và phân tích chi tiết
Bài báo có bốn nhóm thực nghiệm. Mỗi phép thử dưới đây được trình bày theo thứ tự: câu hỏi nghiên cứu, cách làm, kết quả, và phân tích.
Cấu hình huấn luyện chung (Bảng I)
| Mô hình | Số epoch | Batch size | Backbone |
|---|---|---|---|
| DETR | 100 | 8 | ResNet-50 |
| Faster R-CNN | 100 | 8 | ResNet-50-FPN |
| YOLOv7 | 100 | 8 | Darknet |
Ba mô hình được huấn luyện cùng số epoch và batch size, nên so sánh khá công bằng về ngân sách huấn luyện. Faster R-CNN dùng FPN (Feature Pyramid Network), một kỹ thuật kết hợp đặc trưng nhiều tầng để phát hiện vật nhỏ tốt hơn. Đây là đối thủ mạnh ở mảng vật thể nhỏ.
Phép thử 1: RSI có đủ sức phân biệt hai nhóm bệnh nhân không?
Câu hỏi. Nếu có hộp tuyến giáp và hộp vai hoàn hảo (do bác sĩ vẽ), liệu chỉ riêng RSI có đủ để chẩn đoán? Nếu câu trả lời là không, thì làm detector tốt đến đâu cũng vô ích.
Cách làm. Tính RSI từ hộp ground truth bằng công thức (3) trên tập train. Huấn luyện hồi quy logistic với đầu vào là RSI, đầu ra là nhãn còn / không còn mô giáp. Đánh giá trên tập test.
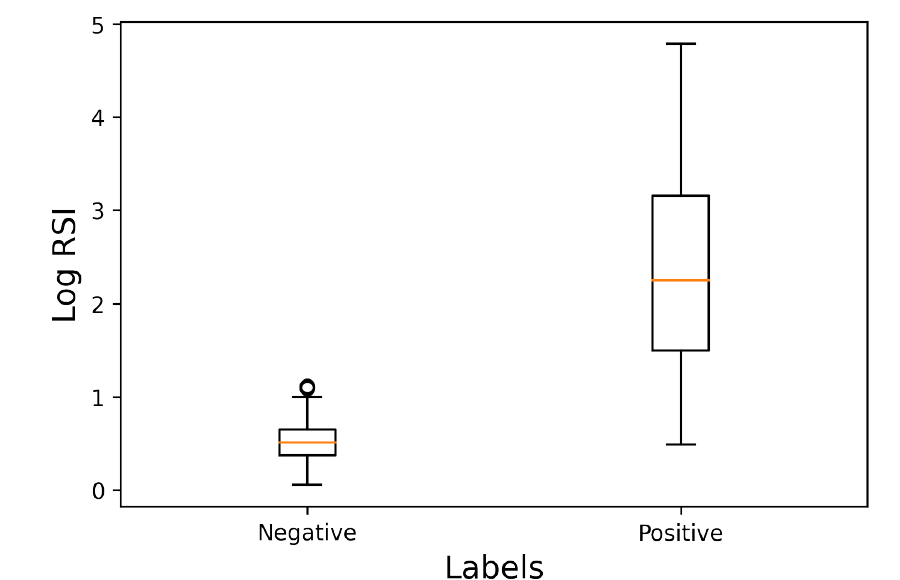
Hình 3 (trích bài báo). Boxplot của log RSI trên tập train theo hai nhóm.
Kết quả.
- Trung vị log RSI: khoảng 0,5 ở nhóm không còn mô giáp và khoảng 2,25 ở nhóm còn mô giáp.
- Hai “hộp” (khoảng tứ phân vị, IQR) không chồng lên nhau: nhóm âm tính nằm trong khoảng 0,4–0,65, nhóm dương tính trong khoảng 1,5–3,15.
- Chẩn đoán trên tập test: Accuracy 0,96 · Precision 0,86 · Recall 0,95 · F1 0,91.
Phân tích.
- RSI là một đặc trưng phân loại mạnh. Khoảng cách giữa hai trung vị (~1,75 đơn vị log) lớn hơn nhiều so với độ rộng IQR của mỗi nhóm. Gần như mọi ca âm tính có log RSI dưới 1, còn 75% ca dương tính có log RSI trên 1,5.
- Vùng xám nằm ở khoảng log RSI 0,5–1,1. Râu dưới của nhóm dương tính kéo xuống ~0,5, chồng với phần trên của nhóm âm tính (râu trên ~1 và vài điểm ngoại lai ~1,1). Đây là những ca mô giáp còn sót rất ít, hấp thụ yếu. Các ca này có thể giải thích vì sao Precision (0,86) thấp hơn Recall (0,95): ngưỡng quyết định nằm ở phía thấp của vùng xám, nên mô hình ít bỏ sót nhưng chấp nhận một số dương tính giả.
- Recall 0,95 phù hợp với ưu tiên lâm sàng. Bỏ sót một ca còn mô giáp nguy hiểm hơn việc gọi bệnh nhân đi xét nghiệm thêm. Với ca nghi ngờ, bác sĩ vẫn có thể dùng thêm TSH và Thyroglobulin (Tg).
- Phân bố nhóm dương tính rất rộng (log RSI 0,5–4,8, tức RSI chênh nhau hàng chục lần). Điều này hợp lý về sinh học vì lượng mô giáp còn sót dao động từ vài mảnh nhỏ đến cả thùy. Đây cũng là lý do nên dùng thang log: nó nén khoảng giá trị lớn và làm phân bố cân hơn cho mô hình logistic.
Phép thử 2: DETR có thực sự tốt hơn CNN khi không có mẹo tiền xử lý?
Câu hỏi. Lợi thế về quan hệ không gian của DETR có thể hiện được không, khi tất cả mô hình chỉ nhận ảnh gốc (1 mức sáng)?
Cách làm. Huấn luyện DETR, Faster R-CNN, YOLOv7 trên ảnh gốc, đo [email protected] cho từng lớp trên tập test (dòng “1 mức sáng” của Bảng III).
Kết quả.
| Mô hình (1 mức sáng) | Thyroid [email protected] | Shoulder [email protected] | [email protected] |
|---|---|---|---|
| DETR | 0,246 | 0,120 | 0,183 |
| Faster R-CNN | 0,375 | 0,079 | 0,227 |
| YOLOv7 | 0,00088 | 0 | 0,00044 |
Phân tích.
- Vai là lớp khó nhất với mọi mô hình. Trên ảnh gốc, vai gần như vô hình, nên mAP của vai thấp ở cả ba mô hình. Tuy vậy DETR vẫn phát hiện vai tốt nhất (0,120 so với 0,079 của Faster R-CNN), đúng với giả thuyết: khi không có đặc trưng cục bộ, mô hình phải dựa vào vị trí tương đối so với cổ và đầu, và attention làm việc này tốt hơn.
- Với tuyến giáp, Faster R-CNN lại tốt hơn. Tuyến giáp còn sót là một điểm sáng nhỏ, có đặc trưng cục bộ rõ. Đây là sở trường của CNN có FPN. Kết quả này phù hợp với hiểu biết chung rằng DETR gốc không mạnh ở vật nhỏ.
- YOLOv7 sụp đổ hoàn toàn (mAP ≈ 0) trên ảnh gốc. Khả năng cao là các anchor và cơ chế gán nhãn của YOLO không tìm được mẫu dương tính có ý nghĩa khi ảnh gần như đen, nên mô hình không học được gì. Đây là ví dụ cho thấy chất lượng đầu vào quan trọng hơn kiến trúc.
- Kết luận của phép thử: ở mức ảnh gốc, chưa mô hình nào dùng được trong thực tế. Lợi thế của DETR chỉ thể hiện ở vai, mà vai lại chính là mẫu số của RSI. Điều đó dẫn tới phép thử tiếp theo: làm sao để vai “hiện ra”.
Phép thử 3: Thêm bao nhiêu mức sáng là đủ?
Câu hỏi. Ghép nhiều phiên bản độ sáng thành các kênh có giúp mô hình thấy đường viền cơ thể và vai không? Bao nhiêu mức là tối ưu?
Cách làm. Với mỗi mô hình, huấn luyện với 1, 2, 3, 4 mức sáng và đo [email protected] trên tập test.
Kết quả (Bảng III).
| Mô hình | # Mức sáng | Thyroid [email protected] | Shoulder [email protected] | [email protected] |
|---|---|---|---|---|
| DETR | 1 | 0,246 | 0,120 | 0,183 |
| DETR | 2 | 0,330 | 0,150 | 0,240 |
| DETR | 3 | 0,447 | 0,161 | 0,304 |
| DETR | 4 | 0,660 | 0,200 | 0,430 |
| Faster R-CNN | 1 | 0,375 | 0,079 | 0,227 |
| Faster R-CNN | 2 | 0,555 | 0,238 | 0,396 |
| Faster R-CNN | 3 | 0,614 | 0,132 | 0,373 |
| Faster R-CNN | 4 | 0,660 | 0,128 | 0,394 |
| YOLOv7 | 1 | 0,00088 | 0 | 0,00044 |
| YOLOv7 | 2 | 0,523 | 0,014 | 0,268 |
| YOLOv7 | 3 | 0,674 | 0,092 | 0,383 |
| YOLOv7 | 4 | 0,513 | 0,131 | 0,322 |
xychart-beta
    title "[email protected] theo số mức sáng (Bảng III)"
    x-axis "Số mức sáng" [1, 2, 3, 4]
    y-axis "[email protected]" 0 --> 0.5
    line "DETR" [0.183, 0.24, 0.304, 0.43]
    line "Faster R-CNN" [0.227, 0.396, 0.373, 0.394]
    line "YOLOv7" [0.00044, 0.268, 0.383, 0.322]
Thứ tự đường: DETR, Faster R-CNN, YOLOv7.
Phân tích.
- Tăng sáng giúp cả ba mô hình, và giúp nhiều nhất ở bước từ 1 lên 2 mức: YOLOv7 đi từ 0 lên 0,268, Faster R-CNN từ 0,227 lên 0,396. Điều này xác nhận nút thắt ban đầu nằm ở dữ liệu đầu vào, không chỉ ở kiến trúc.
- Chỉ DETR cải thiện đều và đơn điệu theo số mức sáng (0,183 → 0,240 → 0,304 → 0,430). Mỗi kênh thêm vào là một “góc nhìn” khác của cùng một cảnh, và cơ chế attention tận dụng được việc kết hợp thông tin giữa các kênh và giữa các vùng xa nhau.
- Faster R-CNN và YOLOv7 bão hòa sớm rồi dao động. Faster R-CNN đạt đỉnh ở 2 mức, YOLOv7 ở 3 mức. Mẫu hình “lên rồi xuống” này gợi ý các mô hình CNN bắt đầu quá khớp khi đầu vào nhiều kênh hơn mà dữ liệu chỉ có 278 ca huấn luyện. Cũng cần lưu ý với tập test nhỏ, một phần dao động có thể chỉ là nhiễu thống kê.
- Ở 4 mức sáng, DETR có mAP tổng tốt nhất (0,430). Lợi thế đến từ việc DETR cân bằng được cả hai lớp: tuyến giáp ngang với Faster R-CNN (0,66) nhưng vai tốt hơn hẳn (0,200 so với 0,128). Faster R-CNN 2 mức có Shoulder mAP cao nhất bảng (0,238) nhưng tuyến giáp lại kém (0,555).
- Đánh đổi chi phí. Mỗi mức sáng thêm vào làm tăng số kênh đầu vào và thời gian suy luận. Bài báo chọn 4 mức sáng cho cấu hình cuối, vì đây là điểm DETR đạt kết quả tốt nhất và chi phí vẫn chấp nhận được với ảnh 256×256.
Phép thử 4: Chọn mô hình theo mAP hay theo RSIA?
Câu hỏi. Trong quá trình huấn luyện, ta lưu nhiều checkpoint. Nếu chọn checkpoint có [email protected] cao nhất trên tập validation (cách làm thông thường) và checkpoint có RSIA cao nhất (thước đo đề xuất), cái nào cho kết quả chẩn đoán cuối cùng tốt hơn?
Cách làm. Dùng DETR 4 mức sáng. Chọn hai checkpoint:
- Best normal model: checkpoint có [email protected] cao nhất trên validation;
- Best proposed model: checkpoint có RSIA cao nhất (, ).
Với mỗi checkpoint, tính RSI từ hộp dự đoán trên tập test, đưa vào cùng một mô hình logistic đã huấn luyện trên RSI của hộp ground truth (Phép thử 1), rồi đo F1. So sánh thêm với ResNet-50 phân loại trực tiếp theo phương pháp của Phu và cộng sự (NICS 2022).
Kết quả (Bảng IV).
| Chỉ số | Best proposed model (chọn theo RSIA) | Best normal model (chọn theo mAP) | Best ResNet-50 |
|---|---|---|---|
| RSIA | 0,457 | 0,436 | – |
| Thyroid [email protected] | 0,730 | 0,663 | – |
| Shoulder [email protected] | 0,604 | 0,570 | – |
| Shoulder [email protected] | 0,156 | 0,200 | – |
| F1 chẩn đoán | 0,91 | 0,90 | 0,88 |
Phân tích.
- Chọn theo RSIA cho chẩn đoán tốt hơn, dù Shoulder [email protected] thấp hơn. Mô hình chọn theo RSIA có Shoulder [email protected] chỉ 0,156 (so với 0,200), nhưng lại tốt hơn ở mọi chỉ số còn lại: RSIA, Thyroid [email protected], Shoulder [email protected] và quan trọng nhất là F1.
- Vì sao vậy? Với vai, điều quan trọng cho RSI là hộp nằm đúng vùng nền, không cần khớp mép chính xác với nét vẽ mang tính chủ quan của bác sĩ. Do vùng vai có cường độ tương đối đồng đều, dịch hộp vài điểm ảnh gần như không làm đổi . Shoulder [email protected] phạt nặng những sai lệch “vô hại” này, trong khi Shoulder [email protected] và RSIA thì không. Kết quả này cũng giải thích lựa chọn dùng [email protected] cho vai ở phần thước đo.
- Bài học tổng quát: đây là một ví dụ của nguyên lý “chọn mô hình bằng thước đo gần mục tiêu cuối cùng nhất”. Khi detector chỉ là một bước trung gian, tối ưu thẳng cho mAP có thể đi lệch khỏi điều ta thật sự cần (ở đây là RSI đúng).
- Hộp dự đoán gần như thay thế được hộp của bác sĩ. F1 khi dùng hộp của DETR (0,91) ngang với F1 khi dùng hộp ground truth ở Phép thử 1 (0,91). Nghĩa là trong bước chẩn đoán, sai số của detector gần như không làm giảm chất lượng. Đây là điều kiện cần để tự động hóa toàn bộ quy trình.
- So với ResNet-50 (F1 0,88): cách tiếp cận “phát hiện + RSI” tốt hơn phân loại trực tiếp, đồng thời giải thích được (bác sĩ thấy hộp và thấy con số RSI). Lưu ý con số 0,88 là kết quả ResNet-50 trong khuôn khổ so sánh của bài SSP 2023, khác với các con số trên tập ANT-POST trong bài NICS 2022 vì dữ liệu và tập test khác nhau.
Phân tích thêm: đọc kết quả với con mắt phản biện
Phần này là nhận xét của người viết để người đọc hiểu đúng tầm của kết quả, đồng thời gợi ý hướng phát triển.
1. Tập test nhỏ, cần đọc kèm khoảng tin cậy
Tập test có 39 ca. Với cỡ mẫu này, mỗi ca tương ứng khoảng 2,6 điểm phần trăm accuracy. Chênh lệch F1 giữa 0,91 và 0,90 trong Phép thử 4 vì vậy tương đương khoảng một ca bệnh.
Để hình dung độ bất định, xét một ví dụ minh họa: có 20 ca dương tính và mô hình bắt được 19 ca (Recall 0,95). Khoảng tin cậy 95% Wilson cho Recall khi đó là:
Khoảng này rộng, nên các so sánh 0,91 / 0,90 / 0,88 nên được hiểu là xu hướng nhất quán chứ chưa phải khác biệt có ý nghĩa thống kê. Các bước tiếp theo hợp lý là k-fold cross-validation, bootstrap để có khoảng tin cậy, và kiểm định McNemar khi so hai mô hình trên cùng tập test.
2. mAP tuyệt đối thấp chưa chắc là xấu
Shoulder [email protected] chỉ quanh 0,15–0,24, nghe có vẻ rất thấp. Nhưng nhãn của vai vốn chủ quan (mỗi bác sĩ khoanh khác nhau), nên mức trần mAP mà ngay cả một người khác khoanh lại cũng đạt được có thể không cao. Một thí nghiệm đáng làm là đo độ đồng thuận giữa các bác sĩ (inter-observer IoU) trên vùng vai, để biết mô hình còn cách mức “con người” bao xa.
3. Những yếu tố có thể ảnh hưởng đến RSI
- Ellipse nội tiếp là một giả định hình học đơn giản. Mô giáp còn sót có thể nằm lệch, nhiều ổ, hoặc dạng dải. Có thể thử thay ellipse bằng mặt nạ phân vùng (segmentation) hoặc ngưỡng cường độ trong hộp.
- Tổng điểm ảnh phụ thuộc diện tích vùng. Nếu hộp vai to hơn hộp tuyến giáp, tăng theo diện tích. Một biến thể đáng thử là dùng mật độ trung bình để RSI ít phụ thuộc vào kích thước hộp.
- Vai trái và vai phải: dữ liệu có hai vai. Cách gộp (lấy một vai, lấy trung bình hai vai) sẽ ảnh hưởng tới độ ổn định của mẫu số.
4. Hướng mở rộng về mô hình
- Các biến thể DETR mới hơn như Deformable DETR, DINO, RT-DETR hội tụ nhanh hơn và xử lý vật nhỏ tốt hơn bản gốc. Chúng phù hợp với tập dữ liệu nhỏ và đối tượng nhỏ như ở đây.
- Có thể đưa thẳng RSIA vào làm tín hiệu huấn luyện (ví dụ thêm một nhánh hồi quy RSI), thay vì chỉ dùng để chọn checkpoint.
- Kết hợp RSI với TSH, Tg trong một mô hình đa biến để xử lý vùng xám (log RSI 0,5–1,1).
- Kiểm định ngoài (external validation) trên dữ liệu từ bệnh viện và máy chụp khác là bước bắt buộc trước khi dùng lâm sàng.
Giải thích nhanh các khái niệm
- Object detection (phát hiện đối tượng): bài toán vừa phân loại vừa khoanh vùng: mô hình trả về danh sách (lớp, hộp, độ tin cậy).
- Bounding box: hộp chữ nhật bao quanh đối tượng, mô tả bằng tâm và kích thước hoặc hai góc.
- Anchor box và NMS: Faster R-CNN và YOLO đặt sẵn rất nhiều hộp mẫu (anchor) rồi điều chỉnh, sau đó dùng NMS để xóa hộp trùng. DETR không cần cả hai.
- Transformer và attention: kiến trúc ban đầu cho xử lý ngôn ngữ. Mỗi phần tử “nhìn” mọi phần tử khác và tự quyết định cần chú ý vào đâu.
- Object query: vector học được trong DETR, mỗi query chịu trách nhiệm “tìm” tối đa một đối tượng.
- Thuật toán Hungarian: thuật toán tìm cách ghép cặp một – một với tổng chi phí nhỏ nhất giữa hai tập phần tử.
- FPN (Feature Pyramid Network): kết hợp đặc trưng từ nhiều tầng của CNN để phát hiện được cả vật lớn và vật nhỏ.
- Hồi quy logistic: mô hình phân loại tuyến tính, biến một điểm số thành xác suất bằng hàm sigmoid.
- Checkpoint: bản lưu trọng số của mô hình tại một thời điểm trong quá trình huấn luyện.
Các khái niệm nền khác (CNN, ResNet, transfer learning, quá khớp, ma trận nhầm lẫn, AUC) đã được giải thích trong bài NICS 2022.
Thuật ngữ y khoa liên quan
- Cắt toàn bộ tuyến giáp (total thyroidectomy): phẫu thuật cắt bỏ toàn bộ tuyến giáp, thường áp dụng cho ung thư tuyến giáp thể biệt hóa.
- Điều trị I-131 (radioiodine ablation): sau mổ, bệnh nhân uống iốt phóng xạ I-131. Mô giáp còn sót và tế bào ung thư biệt hóa hấp thụ iốt nên bị bức xạ tiêu diệt.
- Xạ hình SPECT với I-131: camera gamma ghi lại nơi I-131 tập trung. Vùng còn mô giáp hiện sáng trên ảnh, giúp đánh giá việc điều trị đã loại bỏ hết mô giáp hay chưa.
- Hấp thụ (uptake): mức độ một vùng mô giữ lại chất phóng xạ, thể hiện bằng số đếm photon trên ảnh.
- TSH, Thyroglobulin (Tg): xét nghiệm máu dùng kèm hình ảnh để theo dõi sau điều trị.
Câu hỏi thường gặp (FAQ)
RSI là gì và tại sao lại dùng vai làm mốc? RSI (Radioiodine Scan Index) là tỷ số giữa tổng hấp thụ phóng xạ ở vùng tuyến giáp và ở vùng vai trên cùng một ảnh. Vai gần cổ nhưng không có mô giáp, nên là vùng nền phù hợp. Chia cho vùng nền giúp loại bỏ ảnh hưởng của liều thuốc, thời điểm chụp và máy chụp.
Vì sao không dùng thẳng một mạng CNN để phân loại? Cách đó (ResNet-50, bài NICS 2022) cho F1 0,88 và khó giải thích. Cách “phát hiện + RSI” cho F1 0,91, đồng thời bác sĩ thấy được vùng mô hình khoanh và con số RSI để tự kiểm tra.
DETR khác gì YOLO hay Faster R-CNN? DETR dùng Transformer để mọi vùng trong ảnh “nhìn thấy” nhau, và dự đoán trực tiếp một tập đối tượng thông qua ghép cặp Hungarian, không cần anchor hay NMS. Trong bài này, DETR phát hiện vai (vùng gần như không có đặc trưng cục bộ) tốt hơn hai mô hình CNN.
Vì sao phải tăng độ sáng ảnh? Vai không hấp thụ iốt nên gần như vô hình trên ảnh gốc. Các phiên bản ảnh sáng hơn làm lộ đường viền cơ thể, giúp mô hình định vị vai. Với DETR, mAP tăng từ 0,183 (1 mức sáng) lên 0,430 (4 mức sáng).
RSIA khác mAP thế nào? mAP đo hộp dự đoán có trùng hộp thật không. RSIA đo RSI tính từ hộp dự đoán có đủ gần RSI thật không (sai lệch log-RSI ≤ ε). Chọn mô hình theo RSIA cho kết quả chẩn đoán tốt hơn chọn theo [email protected].
Mô hình này có thay thế bác sĩ không? Không. Đây là công cụ hỗ trợ: nó khoanh vùng, tính RSI và đưa ra gợi ý. Với ca nằm ở vùng xám, bác sĩ vẫn cần kết hợp TSH, Tg và kinh nghiệm lâm sàng.
Trích dẫn
Trích dẫn bài báo (IEEE):
M. L. Phu, T. T. Nguyen, T. V. Pham, T. H. Nguyen, D. T. Pham, M. D. Chu, C. T. Nguyen, Q. L. Tran, D. T. Nguyen, N. H. Le, H. S. Mai, T. N. Nguyen, T. P. Nguyen, Q. K. Le, and N. T. Dang, “Utilizing DETR model on SPECT image to assess remaining thyroid tissues post-thyroidectomy,” in Proc. SSP 2023, 2023, pp. 537–541.
BibTeX:
@inproceedings{phu2023detr,
  title     = {Utilizing DETR model on SPECT image to assess remaining thyroid tissues post-thyroidectomy},
  author    = {Phu, Minh Lai and Nguyen, Thanh Trung and Pham, Thanh Vinh and Nguyen, Thai Ha and Pham, Duc Thuc and Chu, Minh Duc and Nguyen, Chi Thanh and Tran, Quoc Long and Nguyen, Duc Thuan and Le, Ngoc Ha and Mai, Hong Son and Nguyen, Thi Nhung and Nguyen, Thi Phuong and Le, Quoc Khanh and Dang, Nam Thang},
  booktitle = {SSP 2023},
  pages     = {537--541},
  year      = {2023},
  publisher = {IEEE}
}
Tài liệu tham khảo của bài báo
- M. Matsuu-Matsuyama et al., “Age-dependent effects on radiation-induced carcinogenesis in the rat thyroid,” Scientific Reports, vol. 11, no. 1, p. 19096, 2021.
- Y. Guo et al., “Classification and diagnosis of residual thyroid tissue in SPECT images based on fine-tuning deep convolutional neural network,” Frontiers in Oncology, vol. 11, 2021.
- M. L. Phu et al., “A deep learning method using SPECT images to diagnose remaining thyroid tissue post-thyroidectomy,” in 2022 9th NAFOSTED Conference on Information and Computer Science (NICS), IEEE, 2022, pp. 93–98.
- F. Abdolali et al., “Automated thyroid nodule detection from ultrasound imaging using deep convolutional neural networks,” Computers in Biology and Medicine, vol. 122, p. 103871, 2020.
- C.-Y. Wang, A. Bochkovskiy, H.-Y. M. Liao, “YOLOv7: Trainable bag-of-freebies sets new state-of-the-art for real-time object detectors,” arXiv:2207.02696, 2022.
- S. Ren et al., “Faster R-CNN: Towards real-time object detection with region proposal networks,” in Advances in Neural Information Processing Systems 28, 2015.
- N. Carion et al., “End-to-end object detection with transformers,” in Computer Vision – ECCV 2020, Springer, 2020, pp. 213–229.
- M. Everingham, S. A. Belongie, A. Zisserman, “Object detection performance evaluation,” 2007, pp. 1–8.
Tài liệu bổ sung (không có trong danh mục tham khảo của bài báo, được thêm vào để giải thích khái niệm):
- A. Vaswani et al., “Attention is all you need,” in Advances in Neural Information Processing Systems 30, 2017. (positional encoding, attention)
- H. Rezatofighi et al., “Generalized intersection over union: A metric and a loss for bounding box regression,” in Proc. IEEE/CVF CVPR, 2019. (GIoU)
- T.-Y. Lin et al., “Feature pyramid networks for object detection,” in Proc. IEEE CVPR, 2017. (FPN)
- E. B. Wilson, “Probable inference, the law of succession, and statistical inference,” Journal of the American Statistical Association, vol. 22, no. 158, pp. 209–212, 1927. (khoảng tin cậy Wilson)
Bài viết tóm tắt và diễn giải nội dung bài báo gốc nhằm mục đích phổ biến kiến thức. Nội dung này không phải lời khuyên y khoa. Số liệu được trích từ bài báo IEEE SSP 2023 nêu trên; phần “Phân tích thêm” là nhận xét của người viết.
Phía sau sổ tay
Viết bởi danielpham, AI Engineer.